Note for Computer Network 2
副标题:阅读《网络是怎么连接的(户根勤)》读书笔记2
生成 HTTP 请求消息
动作:对URL 进行解析
效果:浏览器确定了 Web 服务器和文件名
后续:根据这些信息来生成 HTTP 请求消息
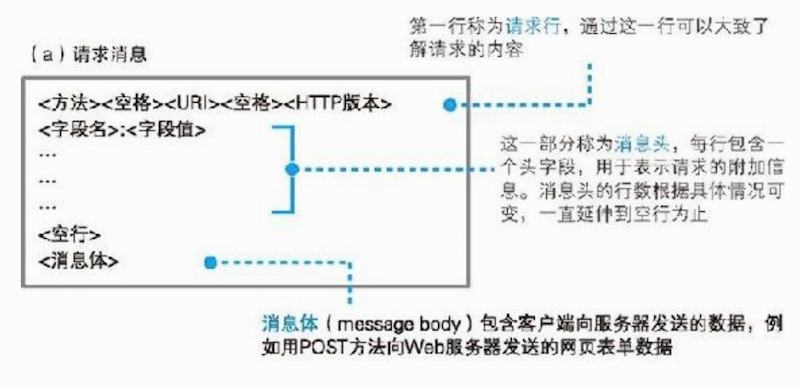
- 消息头存放“请求行没说清楚的”额外信息,消息头的规格中定义了很多项目,如日期、客户端支持的数据类型、语言、压缩格式、客户端和服务器的软件名称和版本、数据有效期和最后更新时间等。比如Date、Pragma、Cache-control、Connection、Transfer-Encoding、Via等,参考HTTP头字段-wiki百科
- 写完消息头之后,还需要添加一个完全没有内容的空行,然后写上需要发送的数据(即消息体)
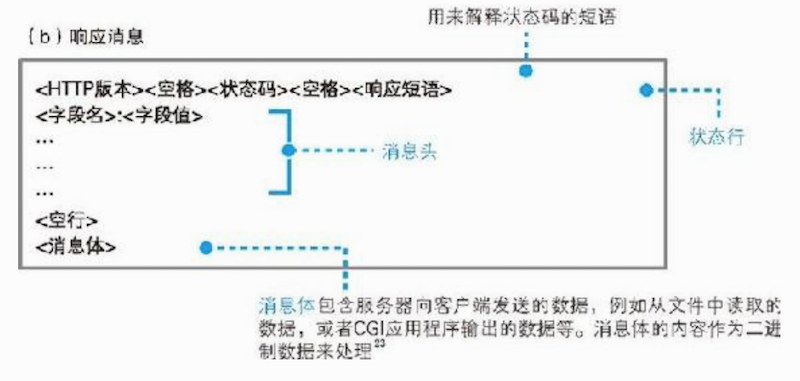
- 响应消息与请求消息差别仅在第一行,内容为状态码和响应短语,用来表示请求的执行结果是成功还是出错。
| 状态码 | 含义 |
|---|---|
| 1xx | 告知请求的处理进度和情况 |
| 2xx | 成功 |
| 3xx | 表示需要进一步操作 |
| 4xx | 客户端错误 |
| 5xx | 服务器错误 |
- 返回响应消息之后,浏览器会将数据提取出来并显示在屏幕上,我们就能够看到网页的样子了。如果网页的内容只有文字,那么到这里就全部处理完毕了,但如果网页中还包括图片等资源,则还有下文
- 当网页中包含图片时,会在网页中的相应位置嵌入表示图片文件的标签的控制信息。浏览器会在显示文字时搜索相应的标签,当遇到图片相关的标签时,会在屏幕上留出用来显示图片的空间,然后再次访问 Web服务器,按照标签中指定的文件名向Web服务器请求获取相应的图片并显示在预留的空间中
[扩展思考]就是因为图文的异步,所以可以考虑采用多线程的方式,先刷出文字,后刷出图片,提升浏览器阅读体验 - 由于每条请求消息中只能写 1 个 URI,所以每次只能获取 1 个文件,如果需要获取多个文件,必须对每个文件单独发送 1 条请求。即,3张图片==额外3次request